NVIDIA lance un modèle d'IA de 120 milliards de paramètres et deux modèles d'informatique en périphérie
fr.wedoany.com Rapport : Le 15 octobre, l'américain NVIDIA a annoncé l'extension de la série de modèles ouverts Nemotron 3.5, avec le lancement du modèle multimodal Nemotron 3.5 Super VL de 120 milliards de paramètres, ainsi que des modèles Nemotron 3.5 Bolt 74B-A9B et Bolt E4B destinés aux appareils de calcul locaux. Parmi eux, les versions Super VL et 74B sont déjà officiellement disponibles, et la version 4 Go devrait être publiée le 23 octobre. Les trois modèles ciblent respectivement les agents d'IA d'entreprise, les appareils de calcul personnels et les terminaux embarqués en périphérie.
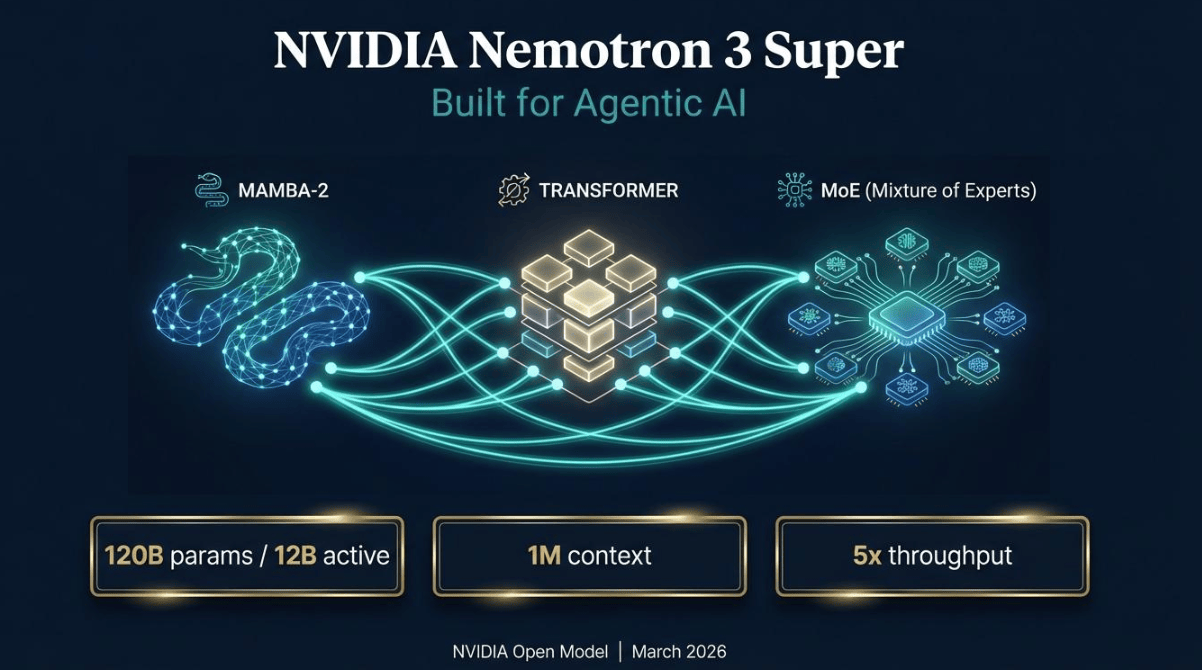
Super VL a été développé par NVIDIA en collaboration avec la Nemotron Coalition, et prend en charge l'exécution d'instructions, l'appel d'outils, le traitement métier multi-étapes et la compréhension visuelle. Les résultats de tests publiés par NVIDIA montrent que la précision de ce modèle sur les tâches multimodales atteint un niveau proche de celle de son grand modèle de raisonnement, avec une taille de paramètres représentant environ un cinquième de ce dernier. Dans la comparaison des performances avec des modèles ouverts similaires, son débit d'inférence atteint jusqu'à 5 fois celui des modèles concurrents. Ce modèle peut traiter des pages web et des fichiers PDF contenant du texte, des images, des graphiques et des tableaux, et prend en charge l'entraînement personnalisé basé sur les données internes de l'entreprise.
L'entraînement de Super VL a utilisé environ 26 billions de tokens de pré-entraînement et de pré-entraînement continu, ainsi qu'environ 3,8 millions d'échantillons de post-entraînement, combinés à plusieurs environnements d'apprentissage par renforcement pour optimiser les performances du modèle. NVIDIA a également ouvert les poids du modèle, les méthodes d'entraînement et les jeux de données couvrant l'appel d'outils, les activités financières, le traitement de contextes longs, la sécurité et la compréhension visuelle et linguistique. Les développeurs peuvent effectuer le fine-tuning et l'entraînement par renforcement du modèle via NVIDIA NeMo et NeMo Gym, et déployer le modèle à l'aide des microservices NVIDIA NIM.
Le Bolt 74B-A9B destiné à l'exécution locale adopte une architecture à mélange d'experts, avec un nombre total de paramètres de 74 milliards et environ 9 milliards de paramètres activés par inférence. Grâce à une technique native de quantification en 2 bits, ce modèle limite la mémoire nécessaire à son exécution à 24 Go, et peut être déployé sur les ordinateurs GeForce RTX, DGX Spark, DGX Station et les stations de travail RTX PRO. NVIDIA fournit déjà un support d'exécution pour llama.cpp, Ollama, LM Studio, Unsloth et vLLM, permettant aux utilisateurs d'effectuer localement des tâches d'agent telles que la rédaction de code, le débogage logiciel et la recherche d'informations.
L'autre modèle, le Bolt E4B, est destiné aux configurations avec 4 Go de mémoire et compatible avec les plateformes GeForce RTX, Jetson et RTX Spark ; il prend en charge les conversations multi-tours, les assistants vocaux, les personnages interactifs et les terminaux intelligents embarqués. NVIDIA le positionne sur les applications d'intelligence artificielle physique et d'agents conversationnels, couvrant les appareils grand public, les systèmes d'interaction embarqués dans les véhicules et d'autres terminaux nécessitant une inférence locale.
NVIDIA a également publié les avancées en matière de personnalisation d'entreprise et d'intégration logicielle de Super VL. Scale AI a réalisé le post-entraînement du modèle pour l'agent de financement fournisseur de Skydance et l'agent de due diligence de fusion-acquisition d'EY ; AfterQuery a développé un modèle d'analyse d'accords de crédit pour Hebbia ; Mercor a utilisé les données d'évaluation de code APEX-SWE pour entraîner le modèle. Atlassian, CrowdStrike, Dassault Systèmes, Perplexity, Salesforce et Synopsys ont également entrepris des intégrations liées respectivement à la recherche, à l'analyse de sécurité, à l'ingénierie, aux processus gouvernementaux et à la vérification de conception de semi-conducteurs.
Dans le déploiement de l'inférence, Super VL prend en charge l'environnement d'exécution NVIDIA Dynamo. Les données de performance publiées par NVIDIA indiquent que cette combinaison, dans la configuration de test correspondante, peut prendre en charge jusqu'à 8 fois plus d'utilisateurs tout en réduisant la latence de 85 %. Le modèle est désormais disponible via Hugging Face, OpenRouter, ModelScope et NVIDIA NIM ; les entreprises peuvent le déployer sur leurs propres serveurs, dans des centres de données ou dans des environnements de cloud computing, et continuer à entraîner et à ajuster le modèle selon leurs processus métier internes.
Produits Associés

Tablette PC industrielle robuste 10 pouces Win10 Win11 Pro Intel N100 16+512 Go IP67 4G avec code-barres NFC RJ45 et station d'accueil
Highton Electronics Co., Ltd.
QPS-20A Commutateur rapide de l'alimentation redondante
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.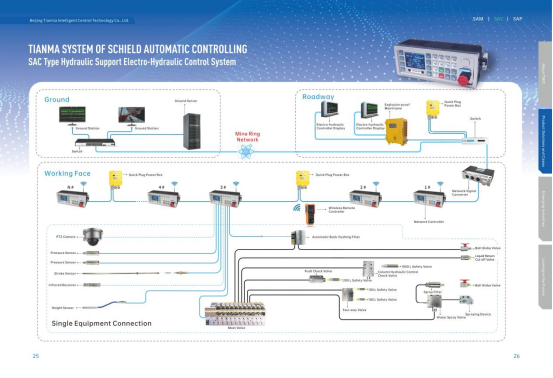
25 Système de contrôle électro-hydraulique pour supports hydrauliques SAC
Beijing Tianma Intelligent Control Technology Co., Ltd.
Système de supervision intelligente en boucle fermée pour la sécurité du transport routier
Beijing Bower Logistics Co., Ltd.
Réflectomètre optique dans le domaine temporel (OTDR) 6422
Ceyear Technologies Co., Ltd.
Tour de communication à quatre colonnes pour les lignes dédiées aux passagers
Henan Dingli Pole & Tower Co.,Ltd.
Radar de profil de vent troposphérique TWP16 en bande P
China Huayun Meteorological Technology Group Co., Ltd.
Système de gestion du cycle de vie des équipements
AURY (TIANJIN) INDUSTRY GROUP CO., LTD.