Supermicro, IBM et NVIDIA lancent une solution de cache pour l'inférence IA
fr.wedoany.com Rapport : Le 5 novembre, le fabricant américain de serveurs Supermicro, en collaboration avec IBM et NVIDIA, a lancé une solution de stockage en cache KV pour l'inférence d'intelligence artificielle, intégrant les serveurs tout-flash Petascale de Supermicro, le logiciel de stockage IBM Storage Scale, le framework d'inférence NVIDIA Dynamo et la technologie Ethernet Spectrum-X. Les trois parties ont mené des tests avec un grand modèle de langage de 120 milliards de paramètres ; dans des conditions d'entrée en contexte long de 130 000 tokens, la vitesse de génération du premier token du système utilisant un cache KV persistant a atteint jusqu'à 56 fois celle de la solution sans cache.
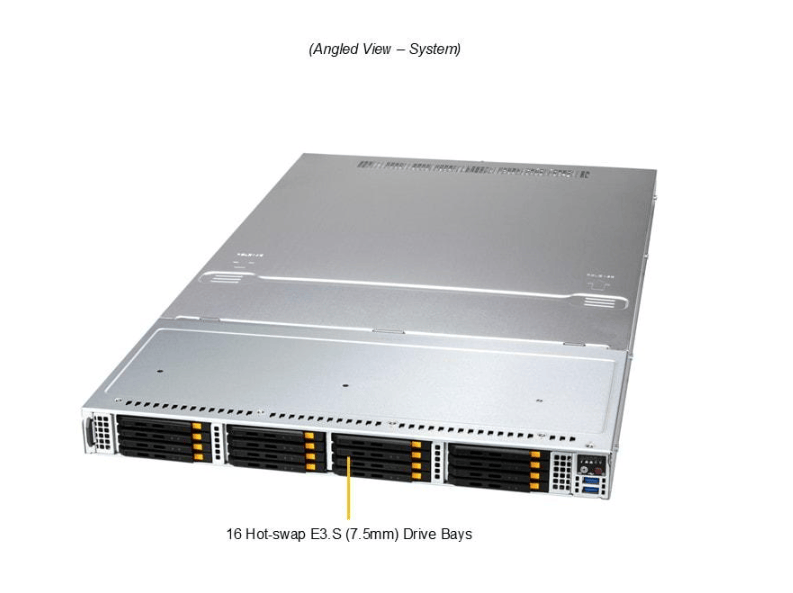
Cette solution utilise des serveurs tout-flash Petascale animés par des processeurs AMD EPYC série 9005 et construit une couche de stockage partagé via IBM Storage Scale avec codage à effacement. NVIDIA Dynamo est chargé des tâches d'inférence distribuée et de la gestion du cache KV, tandis que les commutateurs Ethernet Spectrum-X connectent les nœuds de calcul GPU au cluster de stockage. Le système peut sauvegarder l'état KV déjà calculé dans un espace de stockage partagé en dehors de la mémoire GPU et le rappeler lors de requêtes d'inférence ultérieures.
Dans les tests de contexte long menés conjointement par Supermicro et NVIDIA, à mesure que la longueur d'entrée passait de 30 000 à 130 000 tokens, le temps de génération du premier token du système utilisant un cache KV persistant n'a augmenté que de 0,377 seconde, contre 29,55 secondes pour le système de contrôle sans cache KV. Les résultats des tests correspondent au modèle spécifié, à la configuration matérielle et aux conditions de réutilisation du cache.
Les trois parties ont également réalisé une validation au niveau du cluster dans des environnements à forte concurrence et à contention de ressources réseau. Les résultats des tests techniques publiés par IBM montrent qu'avec l'architecture de cache KV partagé, le débit d'inférence concurrent est passé de 0,19 requête par seconde à 4,26 requêtes par seconde, soit environ 22 fois celui du système de référence, et le temps total de traitement de 200 requêtes a été réduit de 95 %.
Dans les tests de pression réseau, quatre clients concurrents ont généré un trafic réseau compétitif total de 200 Go par seconde. Le système équipé d'IBM Storage Scale maintenait encore 3,6 requêtes d'inférence par seconde, achevant 200 requêtes en 55,56 secondes, avec un débit environ 18 fois supérieur à celui de la solution de référence par recalcul GPU du cache.
Supermicro fournit également pour cette solution des services d'intégration en usine au niveau du rack et de déploiement sur site, couvrant la configuration conjointe des serveurs, des logiciels de stockage, des équipements de commutation réseau et du framework d'inférence. L'entreprise affirme que, grâce à des configurations système prévalidées, le cycle de déploiement de l'infrastructure concernée peut être réduit de plusieurs semaines à quelques jours.
Produits Associés

Terminal satellite portable à panneau plat - Terminal portable manuel de 0,35 mètre
China Starwin Science & Technology co., Ltd.
Calibrateur de pression automatique intelligent ConST811A
Beijing ConST Instruments Technology Inc.
Fabrication intelligente Conception de PCB
GCI Science & Technology (Zhuhai) Co., Ltd.
Fibre optique monomode à dispersion non décalée à bande passante étendue G.652.D
HONGAN GROUP CO. LTD
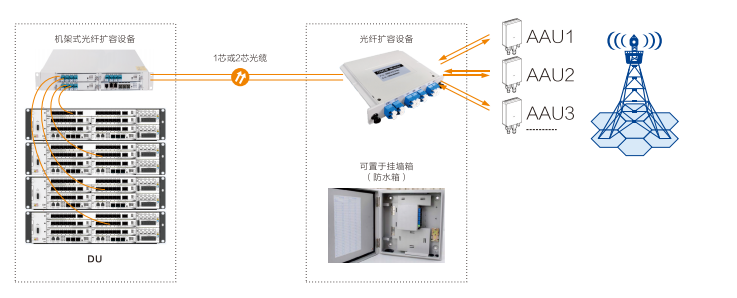
Produit de système de multiplexage par division de longueur d’onde (WDM)
SHENZHEN SDG INFORMATION CO., LTD.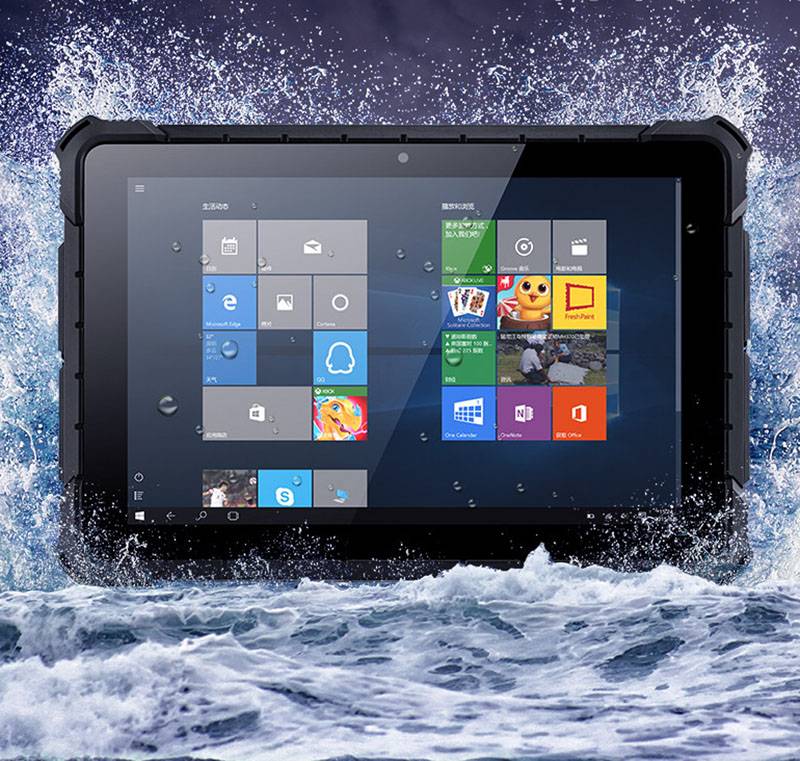
Tablette PC industrielle robuste 10 pouces Win10 Win11 Pro Intel N100 16+512 Go IP67 4G avec code-barres NFC RJ45 et station d'accueil
Highton Electronics Co., Ltd.
Réflectomètre optique dans le domaine temporel (OTDR) 6422
Ceyear Technologies Co., Ltd.
KJD127(A) Ordinateur minier antidéflagrant à sécurité intrinsèque
Taiyuan Xiangming Intelligent Control Technology Co., Ltd.