Microsoft dévoile la puce Maia 300 et prévoit un déploiement de plusieurs gigawatts à partir de 2027
fr.wedoany.com Rapport : Le 12 octobre, Microsoft a annoncé le lancement de Maia 300, sa puce d'inférence d'intelligence artificielle de troisième génération développée en interne, avec pour projet de déployer à partir de 2027 des systèmes de calcul Azure Maia de l'ordre de plusieurs gigawatts dans ses centres de données mondiaux, et d'en faire la principale plateforme d'inférence de ses produits et services d'IA. Microsoft prévoit que Maia 300 traitera 40 % de tokens par mégawatt de plus qu'un système GPU de pointe, et que le débit de tokens d'une baie complète pourra atteindre jusqu'à 7 fois celui de la génération précédente, Maia 200.
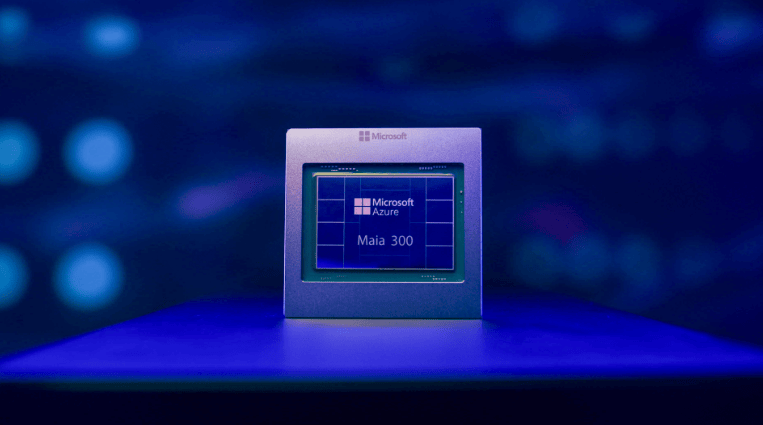
Maia 300 adopte une architecture multi-chiplet, séparant les fonctions de calcul, de contrôleur mémoire et d'entrées-sorties. Le chiplet de calcul est fabriqué selon le procédé TSMC N2P ; la puce intègre 8 groupes de mémoire à haut débit HBM4, une bande passante mémoire de pointe de 18,0 To/s et une puissance de dissipation thermique de 950 watts. Cette puce est optimisée pour l'inférence à long contexte, les calculs intensifs en mémoire et les tâches d'agents d'IA à étapes multiples, et prend en charge le format de calcul en basse précision amélioré MXFP4.
En ce qui concerne la configuration du système serveur, la baie Maia 300 conçue par Microsoft embarque 96 accélérateurs d'IA, pour une puissance totale d'environ 167 kilowatts, intègre 27,6 To de mémoire à haut débit et atteint une bande passante mémoire agrégée de 1,7 Po/s. Les puces communiquent entre elles via un réseau d'interconnexion haut débit dédié, reposant sur une architecture de transmission basée sur Ethernet, et prennent en charge une extension depuis une seule baie jusqu'à des clusters de calcul à l'échelle d'un centre de données.
Microsoft a déjà déployé la génération précédente, Maia 200, dans des centres de données aux États-Unis, en Europe et en Australie, et l'utilise pour Microsoft Copilot ainsi que pour des services internes d'inférence de modèles d'IA. L'entreprise indique que Maia 200 atteint, pour les charges de travail d'IA concernées, une efficacité de traitement de tokens par watt jusqu'à 1,7 fois supérieure à celle d'une infrastructure GPU de pointe. Des produits tels que Microsoft Teams utilisent déjà ces capacités d'inférence, et GitHub Copilot ainsi que Microsoft Foundry prévoient de les intégrer davantage d'ici fin 2026.
Maia 300 entrera en déploiement en environnement de production à partir de 2027, afin de fournir principalement de la puissance de calcul aux applications d'IA propres à Microsoft, couvrant Copilot, GitHub, Microsoft Foundry ainsi que les tâches d'inférence de modèles d'IA de nouvelle génération. Rani Borkar, responsable du matériel des centres de données de Microsoft, a déclaré que l'entreprise n'avait pas l'intention, pour l'instant, de louer directement aux clients cloud la puissance de calcul sous-jacente des puces Maia, et qu'elle donnerait la priorité, à ce stade, aux besoins internes de ses services d'IA.
Produits Associés

KJD127(A) Ordinateur minier antidéflagrant à sécurité intrinsèque
Taiyuan Xiangming Intelligent Control Technology Co., Ltd.
Tablette PC industrielle robuste 10 pouces Win10 Win11 Pro Intel N100 16+512 Go IP67 4G avec code-barres NFC RJ45 et station d'accueil
Highton Electronics Co., Ltd.
Radar de profil de vent troposphérique TWP16 en bande P
China Huayun Meteorological Technology Group Co., Ltd.
25 Système de contrôle électro-hydraulique pour supports hydrauliques SAC
Beijing Tianma Intelligent Control Technology Co., Ltd.
Fibre optique monomode à dispersion non décalée à bande passante étendue G.652.D
HONGAN GROUP CO. LTD
Système de supervision intelligente en boucle fermée pour la sécurité du transport routier
Beijing Bower Logistics Co., Ltd.
Réflectomètre optique dans le domaine temporel (OTDR) 6422
Ceyear Technologies Co., Ltd.
Logiciel de serveur d'applications Baolande V9.5
Beijing Baolande Software Corporation
QPS-20A Commutateur rapide de l'alimentation redondante
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.