
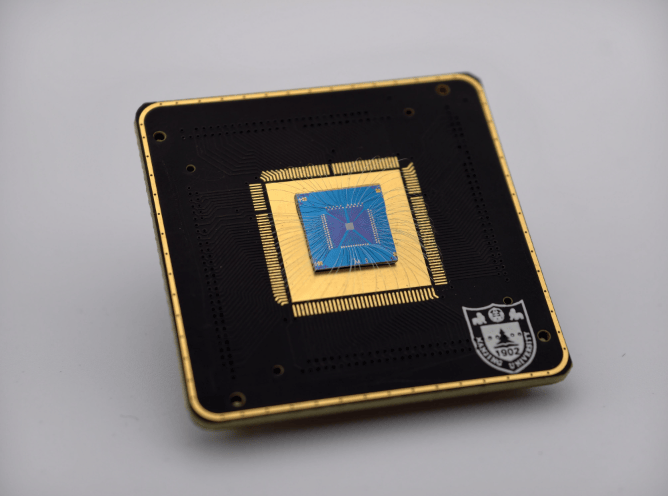
Comment réaliser efficacement et avec une faible consommation d'énergie l'acquisition synchrone et la tokenisation des informations visuelles constitue un défi clé à résoudre dans le domaine du matériel d'intelligence artificielle (IA) physique. Récemment, l'équipe des professeurs Miao Feng et Liang Shijun de l'Université de Nanjing, en collaboration avec l'équipe de l'Université nationale de Singapour, a développé pour la première fois au niveau international une nouvelle puce de capteur visuel intelligent à ultra-faible consommation d'énergie, baptisée « Guangyu Xin », capable de convertir directement la lumière en tokens. Les tokens générés par cette puce peuvent être directement injectés dans un encodeur pour réaliser la reconnaissance d'images. Les résultats de ces recherches ont été publiés en ligne le 19 dans la revue académique internationale Nature Sensing.
Dans des environnements complexes, la capacité de perception autonome, de raisonnement et de prise de décision de l'IA physique dépend fortement de la capacité des appareils en périphérie à exécuter efficacement les grands modèles de vision. Cependant, les appareils en périphérie, limités par la consommation d'énergie et la puissance de calcul, peinent à réaliser une cognition visuelle en temps réel localement.
« Dans la chaîne traditionnelle de perception visuelle, le signal lumineux doit passer par plusieurs étapes — acquisition par le capteur d'image, conversion analogique-numérique, transfert en mémoire tampon, découpage numérique et intégration — avant de générer des tokens exploitables par le modèle. Le transfert fréquent de données redondantes en masse maintient une consommation d'énergie élevée en périphérie », explique Miao Feng. « Nous souhaitons effectuer la tokenisation directement dans le capteur, contournant ainsi ce chemin au niveau physique. »
Dans cette étude, l'équipe a proposé pour la première fois au niveau international de déplacer le processus de génération des tokens en amont, dans le capteur, où l'acquisition d'image, le découpage en blocs et l'intégration des blocs d'image sont réalisés directement.
Liang Shijun indique que la puce « Guangyu Xin » développée par l'équipe est composée d'une matrice de stockage photosensible et de circuits d'adressage périphériques. L'équipe a d'abord construit une matrice de stockage photosensible basée sur des phototransistors à grille flottante en disulfure de molybdène monocouche. Chaque pixel de la matrice combine les trois fonctions de photosensibilité, de stockage et de calcul analogique. Après l'écriture du signal lumineux, celui-ci est conservé in situ sous forme de charge de grille flottante. Les circuits d'adressage périphériques peuvent activer sélectivement des zones de pixels pour réaliser le découpage en blocs de l'image. Pour les blocs d'image sélectionnés, la puce applique ensuite une séquence de tensions spécifique, permettant aux informations lumineuses stockées dans le bloc et à la matrice d'intégration d'effectuer des opérations de multiplication-accumulation dans le domaine analogique, le courant de sortie constituant le token.
« Nous avons réalisé sur la puce un calcul physique où "la lumière entre, et les tokens sortent directement", éliminant fondamentalement le transfert de données, la plus grande source de consommation d'énergie », explique Liang Shijun. Cette méthode de « tokenisation physique » transforme la puce d'un simple enregistreur d'images passif en un générateur actif de sémantique visuelle. Le système d'architecture de conversion visuelle basé sur « Guangyu Xin » atteint un taux de précision de reconnaissance de 87,3 %, proche de la ligne de base de reconnaissance des logiciels traditionnels, et améliore l'efficacité énergétique de la phase de tokenisation de plus de 10 fois par rapport aux solutions conventionnelles.
Miao Feng déclare que ce résultat bouleverse fondamentalement le paradigme séquentiel « d'abord capter la lumière, puis mettre en cache, enfin calculer », ouvrant une nouvelle dimension pour dépasser le plafond de puissance de calcul et de consommation d'énergie de l'IA en périphérie à l'ère post-Moore. Cette technologie devrait fournir une base de cognition visuelle à haute efficacité énergétique et à latence quasi nulle pour des domaines tels que l'IA incarnée, les drones à basse altitude et la sécurité intelligente, accélérant ainsi le déploiement à grande échelle de l'IA physique.