China Unicom publie le livre blanc « Technologies d’optimisation de l’inférence des grands modèles pour l’exploitation des tokens »
fr.wedoany.com Rapport : China Unicom Digital Intelligence, en collaboration avec l’Université Tsinghua, l’Université de Pékin, le Laboratoire Zhijiang et d’autres universités, instituts de recherche et partenaires industriels, a publié le premier livre blanc du secteur intitulé « Technologies d’optimisation de l’inférence des grands modèles pour l’exploitation des tokens ».


Ce livre blanc propose pour la première fois une architecture technique d’inférence en quatre couches : « fusion multi-modèles – optimisation des modèles – fusion modèle-calcul – fusion calcul-réseau-modèle », et systématise les technologies clés de chaque couche ainsi que l’état actuel de l’industrie, en analysant la valeur applicative de ces technologies dans des scénarios métiers réels. Ces technologies visent à réduire le coût de production des tokens, améliorer l’efficacité des services de tokens, garantir la stabilité de l’approvisionnement en tokens, et faire passer les services de grands modèles d’un état « appelable » à un état « exploitable ».
Au niveau de la fusion multi-modèles, cela implique la quantification des limites de capacité des modèles, le routage intelligent, la cascade de modèles et l’intégration de modèles, afin de résoudre le problème de l’adéquation entre différentes requêtes et modèles appropriés.
Au niveau de l’optimisation des modèles, cela inclut les mécanismes d’attention à faible complexité, l’optimisation de l’architecture des experts mixtes, le décodage spéculatif, la quantification des modèles, la distillation des modèles, l’optimisation des chaînes de pensée, la gestion de la mémoire, la compression du cache clé-valeur et l’optimisation des chemins de génération des modèles de diffusion, dans le but de réduire le coût de génération par token.
Au niveau de la fusion modèle-calcul, cela concerne la fusion des opérateurs, l’optimisation de l’accès à la mémoire, l’accélération des opérateurs de base, le réglage des paramètres du moteur et l’adaptation de l’architecture des modèles, afin d’améliorer l’efficacité d’exécution entre les modèles et le matériel.
Au niveau de la fusion calcul-réseau-modèle, cela implique le parallélisme d’inférence multi-machines, le regroupement dynamique par lots, la réutilisation du cache, le routage des sessions persistantes, l’équilibrage de charge, la limitation de débit et la dégradation, afin de garantir un approvisionnement stable des services de tokens à grande échelle.
Produits Associés

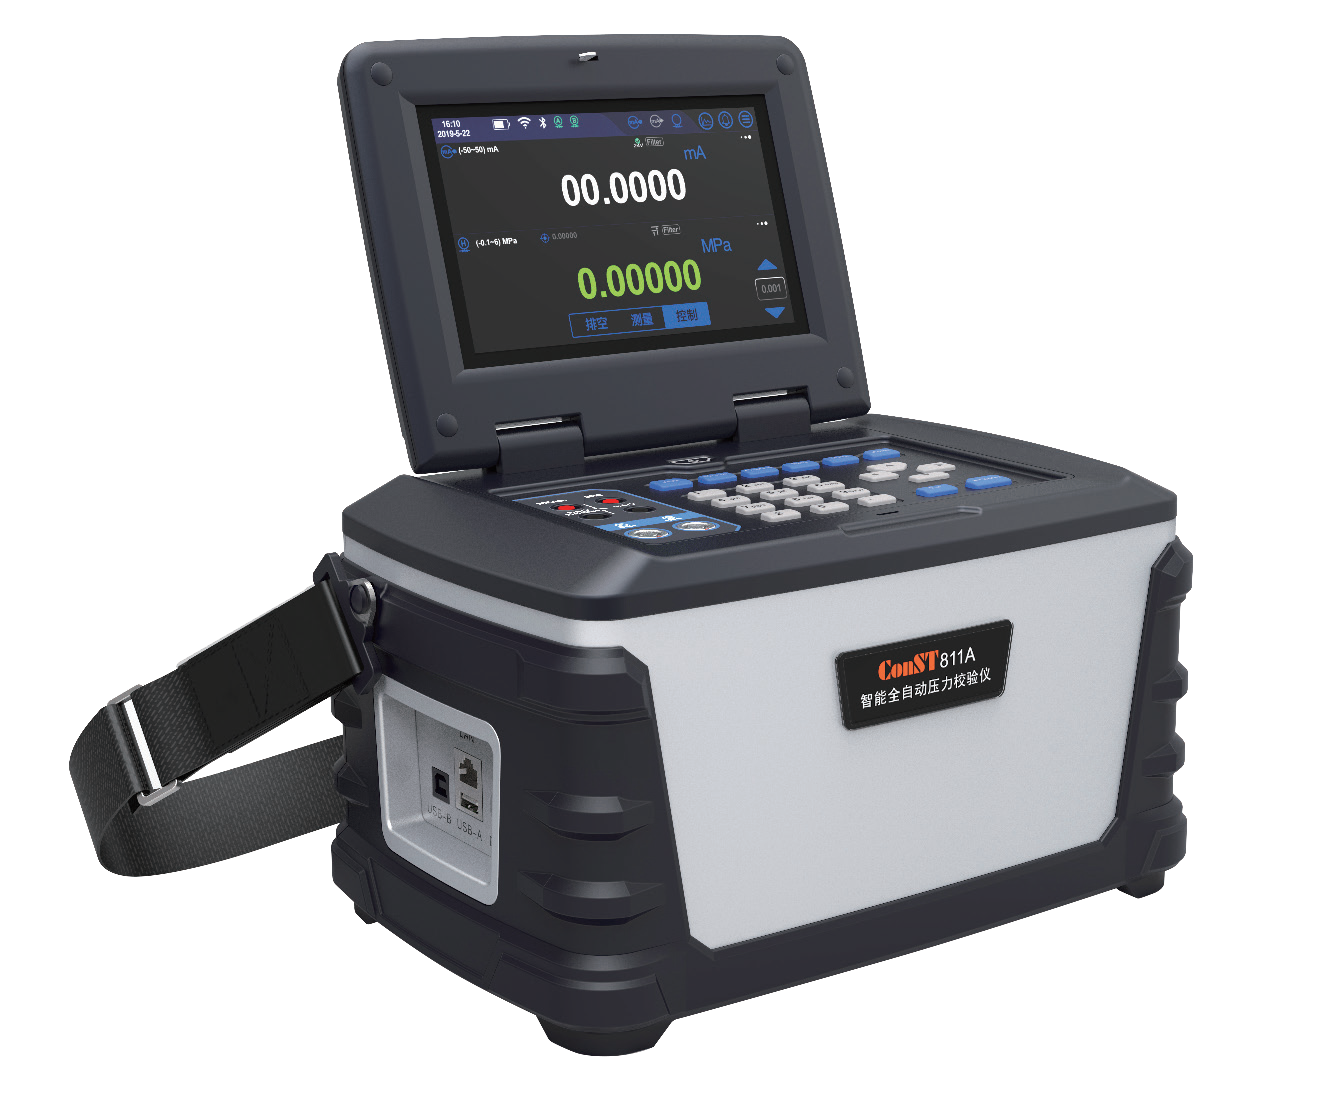
Calibrateur de pression automatique intelligent ConST811A
Beijing ConST Instruments Technology Inc.

Codeur magnétique à anneau incrémental de type 202
Shanghai Complee Instrument Co., Ltd.
Fibre optique monomode à dispersion non décalée à bande passante étendue G.652.D
HONGAN GROUP CO. LTD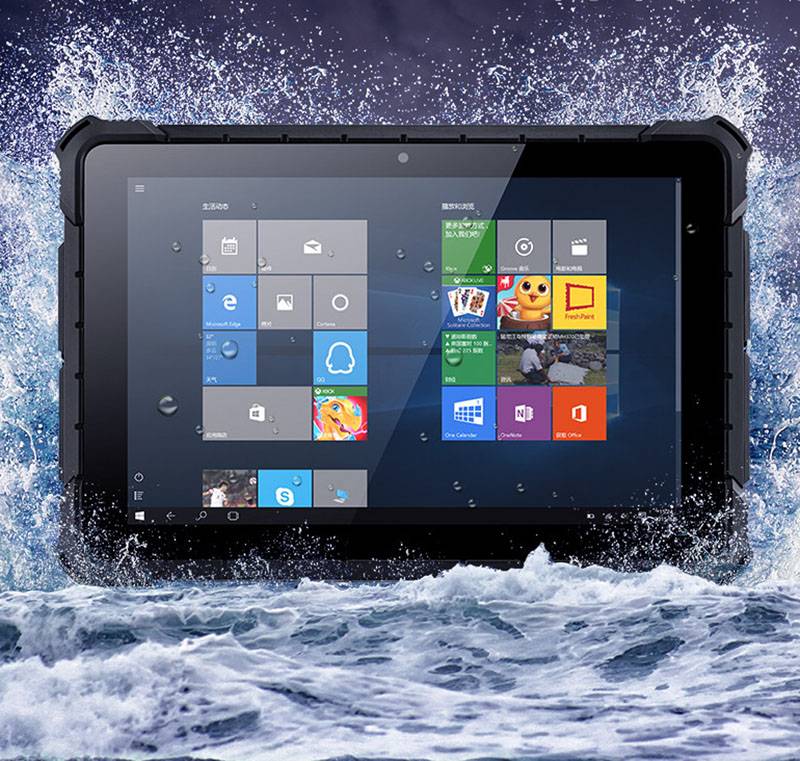
Tablette PC industrielle robuste 10 pouces Win10 Win11 Pro Intel N100 16+512 Go IP67 4G avec code-barres NFC RJ45 et station d'accueil
Highton Electronics Co., Ltd.
Système de surveillance intelligente pour bande transporteuse
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.
Radar multifonction de surveillance océanique et de détection basse altitude, mesure de l'environnement dynamique océanique à la frontière air-mer (Agent/Lancement exclusif) — Fiche technique disponible
Chengdu Dixin Technology Co., Ltd.