Lenovo dévoile le super nœud Wentian, avec une puissance de calcul FP8 supérieure à 28 PFLOPS sur 40 cartes
fr.wedoany.com Rapport : Lenovo a tenu hier une conférence de presse à Pékin. Chen Zhenkuan, vice-président de Lenovo Group et directeur général du groupe d’activités Infrastructures pour la Chine, a annoncé qu’en 2027, le groupe Infrastructures Chine de Lenovo visera un objectif de 100 milliards de yuans RMB, et ambitionnera de devenir le premier sur le marché chinois des serveurs.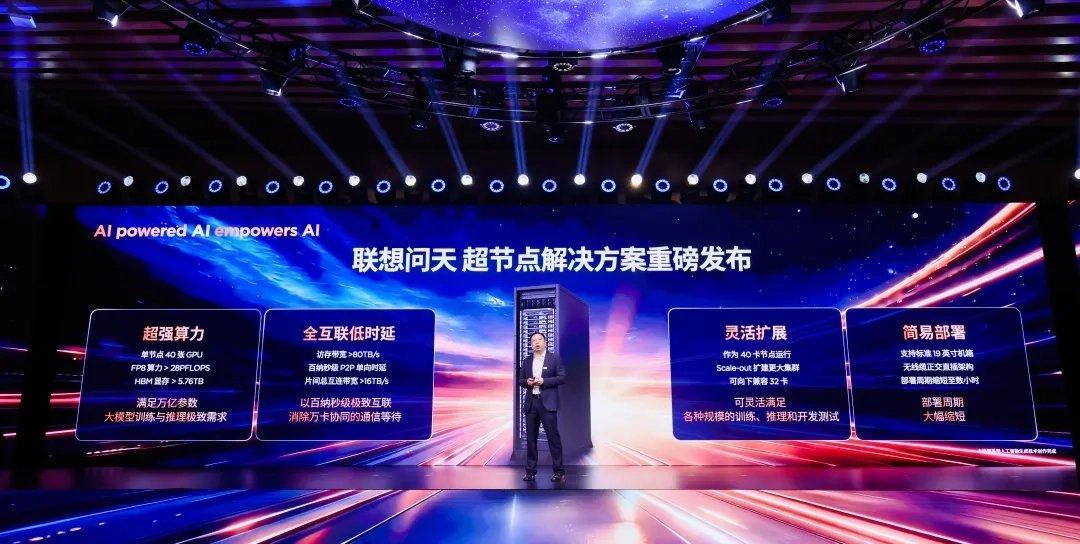
Lors de cette conférence, Lenovo a dévoilé la solution de calcul de super nœud Wentian. Un seul nœud peut accueillir 40 GPU, avec une puissance de calcul FP8 supérieure à 28 PFLOPS, une mémoire HBM dépassant 5,76 To, répondant aux besoins d’entraînement et d’inférence des modèles massifs à des billions de paramètres. La bande passante totale d’accès mémoire dépasse 80 To/s, avec une latence unidirectionnelle P2P entre puces de l’ordre de la centaine de nanosecondes, brisant le goulot d’étranglement de communication des clusters à l’échelle de dizaines de milliers de cartes. Un seul nœud prend en charge 40 cartes, avec une extension horizontale Scale-out du cluster, et est rétrocompatible avec une configuration de 32 cartes, répondant aux besoins d’entraînement, d’inférence et de développement/test à différentes échelles. Adoptant une architecture orthogonale sans câble, compatible avec les boîtiers standard de 19 pouces, le cycle de déploiement du cluster est réduit à quelques heures, abaissant considérablement le seuil de mise en œuvre des clusters de calcul à grande échelle.
Lenovo a également lancé la plateforme de calcul hétérogène Wanquan V5.0, avec deux mises à niveau majeures. La technologie d’accélération de l’entraînement et de l’inférence des clusters, grâce à une architecture PD découplée en couches et à l’optimisation du cache partagé KV Cache, permet une avance globale des performances d’entraînement et d’inférence des grands modèles, améliorant considérablement l’utilisation des ressources du cluster. La technologie d’optimisation de compilation cœur-modèle réalise une adaptation automatique des graphes de calcul et une génération automatique d’opérateurs pour différents modèles, s’adaptant profondément à l’écosystème des puces de calcul diversifiées, améliorant l’efficacité de calcul de l’ensemble du processus d’entraînement et d’inférence.
Texte compilé par Wedoany. Toute citation par IA doit mentionner la source « Wedoany ». En cas de contrefaçon ou d'autre problème, veuillez nous en informer rapidement ; nous modifierons ou supprimerons le contenu le cas échéant. Courriel : news@wedoany.comProduits Associés
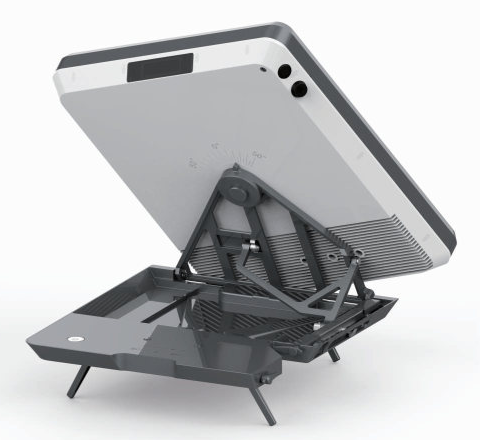

Terminal satellite portable à panneau plat - Terminal portable manuel de 0,35 mètre
China Starwin Science & Technology co., Ltd.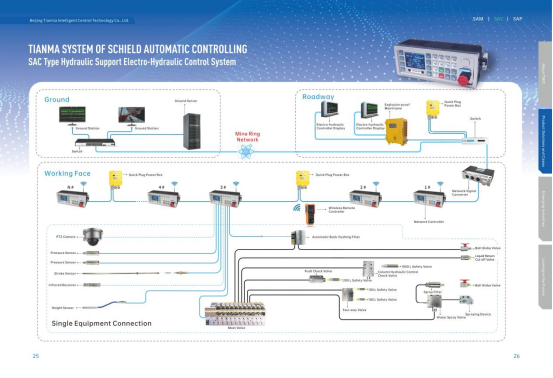
25 Système de contrôle électro-hydraulique pour supports hydrauliques SAC
Beijing Tianma Intelligent Control Technology Co., Ltd.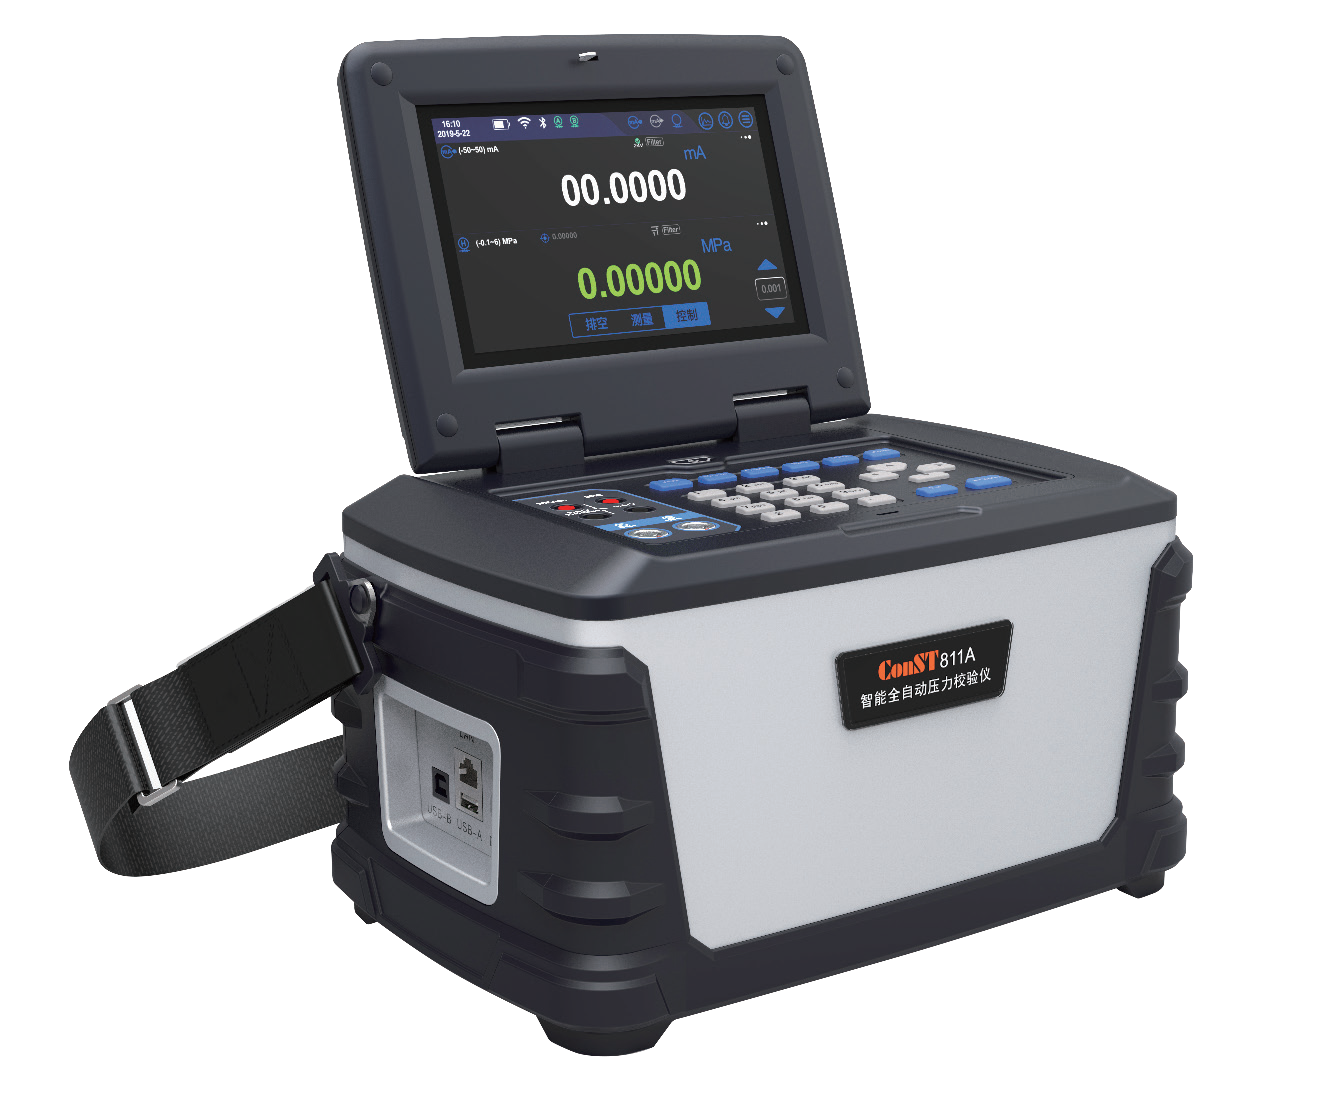
Calibrateur de pression automatique intelligent ConST811A
Beijing ConST Instruments Technology Inc.
Logiciel de serveur d'applications Baolande V9.5
Beijing Baolande Software Corporation
Solution de Prévention des Fuites de Données pour Bureaux
Sangfor Technologies Inc.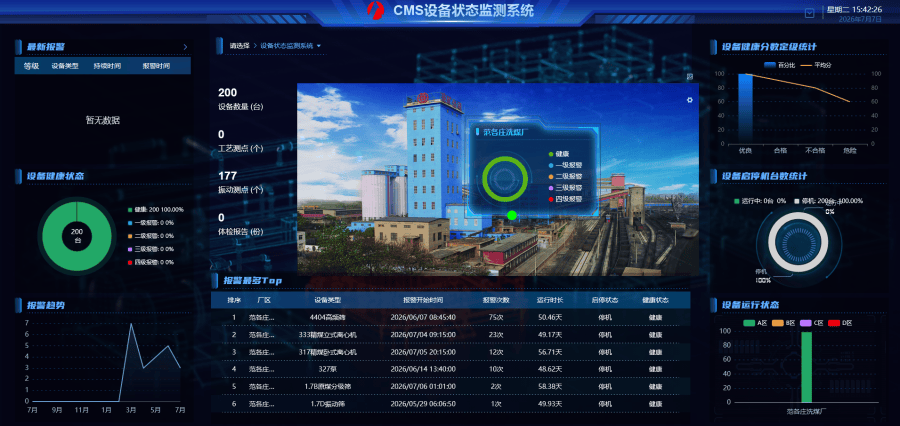
Système de gestion du cycle de vie des équipements
AURY (TIANJIN) INDUSTRY GROUP CO., LTD.
Réflectomètre optique dans le domaine temporel (OTDR) 6422
Ceyear Technologies Co., Ltd.
Produit de système de multiplexage par division de longueur d’onde (WDM)
SHENZHEN SDG INFORMATION CO., LTD.

Radar de profil de vent troposphérique TWP16 en bande P
China Huayun Meteorological Technology Group Co., Ltd.